一位媽媽帶著讀國小五年級的孩子走進診間,手機上開著三個分頁。
孩子鼻塞很久了,晚上睡覺會打呼,白天上課常常恍神。她前一晚查資料查到凌晨兩點,而且查得非常完整:過敏性鼻炎、腺樣體肥大、鼻中膈彎曲、慢性鼻竇炎,甚至查到『長期的睡眠呼吸中止,可能影響孩子的注意力與生長發育』。
她把手機轉過來給我看,然後說:
「醫師,這些我都看過了,可是我還是不知道該怎麼辦。」
這篇是〈AI 給了十個答案之後〉的續篇。那一篇我談的是醫師這一端:答案變多了,判斷反而變貴。但同一件事發生在病人那一端,長出來的是另一個症狀——資訊爆量,理解缺貨。
醫師與病人站在診間的兩側,被 AI 改變的方式並不相同,最後卡住的地方,卻常常是同一個。
我知道大家都忙,先說結論
- 那位媽媽查了三個小時,手上有一整疊資料,卻沒辦法把那疊資料變成一個她敢做的決定。 這就是這個時代最典型的溝通失敗——不是資訊不足,是資訊過剩而理解不足。
- 那份著名的「AI 比醫師更有同理心」研究,醫師輸掉的是字數,不是專業。 醫師回覆中位數 52 個英文單字,聊天機器人 211 個 [1]。
- 但那仍是一記警鐘:病人一旦拿過一份有耐心、不會不耐煩的說明,標準就回不去了。
- 我把病人從「查得到」走到「做得到」的路拆成三道關卡,稱為三次轉譯:醫學語言→生活語言、一般資訊→個人情境、知道→做得到。第一關 AI 做得很好,後兩關不行。
- 衛教寫太難是有證據的:17 份研究、1,124 份頭頸癌病人衛教資料,沒有任何一項研究的平均閱讀難度達到美國醫學會建議的六年級以下 [2]。
那天我沒有先回答她查到的任何一條
我先問了她一個問題:「那妳今天最擔心的,是哪一件事?」
她愣了幾秒,說:「就是⋯⋯不知道會不會很嚴重。」
「嚴重」這兩個字,在每個人心裡指的常常不是同一件事。有人怕的是腫瘤,有人怕的是要不要開刀,有人怕的是從此要一直吃藥。三種怕,需要三種完全不同的說明。AI 給的是通用的答案;診間裡要處理的,是眼前這一個人的怕。
所以我接著問了她三個問題。
「孩子早上起床,會不會常常喊睡不飽?甚至週末放假也一樣?」她說不會。
「上課恍神,是最近才這樣,還是一直都這樣?」她想了想:「導師說是這學期才明顯。」
「家裡晚上大概幾點睡?」她停頓得比較久,才說:「他最近在熬夜,常常拖到十二點多。」
問到這裡,她自己把答案講出來了:「醫師,其實我是怕這個影響到他的發育跟成績⋯⋯」
那一刻,我們才真正開始看診。
這三個問題不是隨便問的。第一題問的是「連週末補眠都補不回來嗎」——如果連放假都睡不飽,那才是睡眠品質本身出了問題;她說不會,這條線就先往後放。第二題問時間軸,把「一直都這樣」和「最近才變成這樣」分開。第三題找那個變化的來源——結果找到了熬夜。
請注意:這不代表鼻塞、打呼、腺樣體不重要,那些仍然要看、要檢查(關於孩子打呼與腺樣體,我另外寫過一篇三位專科醫師的合刊)。三個問題做的事情不是排除診斷,而是重新排序:先處理那個今晚就能改、而且很可能貢獻最大的因素。
前面三個小時的搜尋,把她帶到了一堆病名面前;三個問題,把焦點從『病名』移回『這個孩子』。她需要的不是第四個網頁,而是有人陪她把「怕」變成一個可以被處理的問題。
AI 很會回答,但看診不是問答
先講一個常被誤讀的研究。
2023 年《JAMA Internal Medicine》做了一項橫斷面研究 [1],從公開網路論壇隨機抽出 195 組民眾的真實醫療提問,把醫師的回覆與 AI 聊天機器人的回覆匿名打散,交給有執照的醫療人員評分。結果是:評分者在 585 次評比中,有 78.6% 偏好聊天機器人的回答;在資訊品質與同理心兩個面向,聊天機器人的分數也都顯著較高。
這個數字後來被大量引用,標題常寫成『AI 比醫師更有同理心』。
但同一份研究裡,還有一個常被略過的數字:醫師回覆的中位數是 52 個英文單字,聊天機器人是 211 個。
那是網路論壇上的義務問答。醫師多半是利用看診空檔、免費、順手回一句,本來就不是完整的醫療說明。研究作者自己建議的方向也是『讓 AI 起草、醫師修改』,而不是取代醫師。
換句話說,醫師在那份研究裡輸掉的,是字數,不是專業。
不過這件事反過來也是一記警鐘:當病人第一次拿到一份有耐心、有條理、不會不耐煩的說明,他就會知道,原來說明可以長這樣。標準一旦被拉高,就回不去了。診間裡那幾分鐘的對話,從此是跟一個「永遠不累的說明者」被放在一起比較的。
門診只有幾分鐘,更要花在問對問題
病人拿著 AI 查到的病名來對答案時,怎麼先接住、再把他帶回現場才看得到的資訊,我在〈AI 給了十個答案之後〉寫過;台灣門診只有三到十分鐘的現實,則在〈AI 時代,醫師還剩下什麼?〉談過。
這裡只補一句:背景知識的說明,現在 AI 可以接走大半;醫師省下來的那幾分鐘,應該花在開頭那三個問題上——聽出弦外之音,問出沒被說出來的事。
三次轉譯:從查得到,到做得到
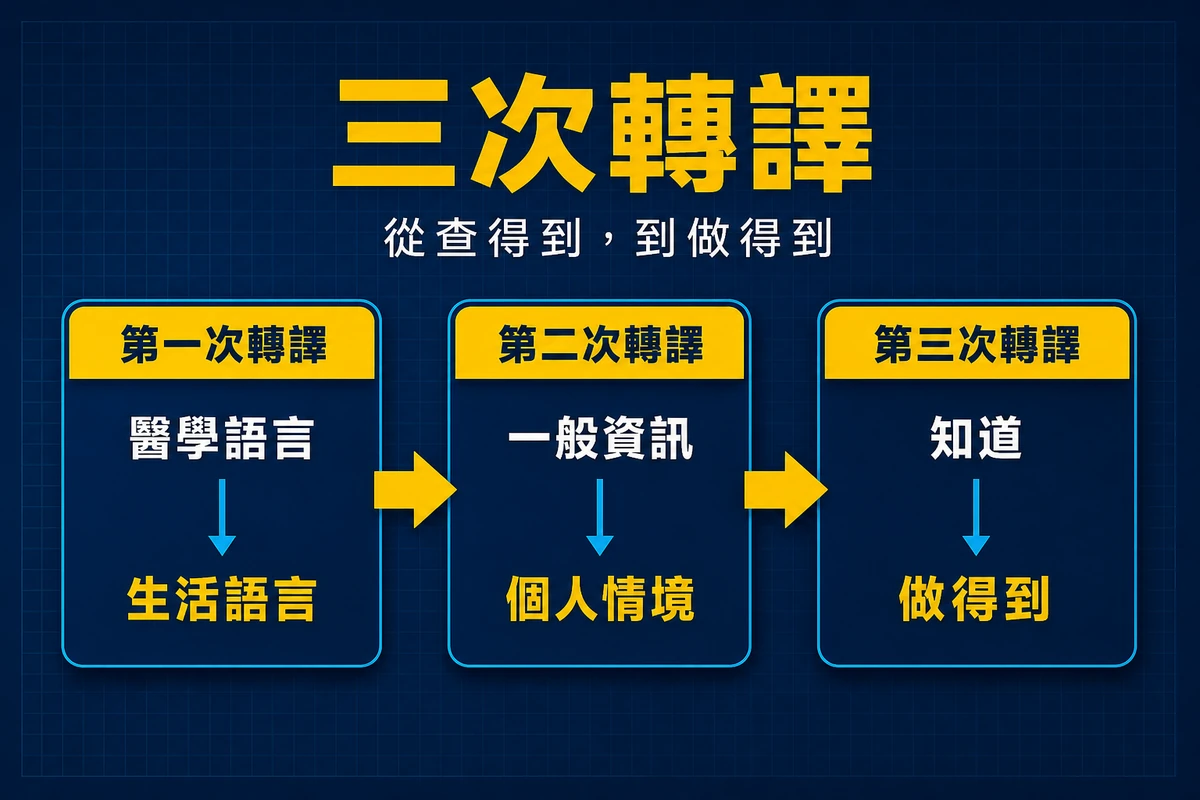
我把病人從「查到資訊」走到「做出行動」的路,拆成三道關卡,稱它為三次轉譯。
第一次轉譯:醫學語言,變成生活語言
『下鼻甲肥厚合併鼻中膈彎曲』是醫學語言。
「你鼻子裡有一邊的通道天生比較窄,加上黏膜長期腫脹,所以躺下來那一側特別塞」是生活語言。
這一關,AI 做得又快又好。老實說,做得比大多數醫師快。
第二次轉譯:一般資訊,變成個人情境
同樣是鼻塞,一個準備考試的小學生、一個天天講電話的業務、一個獨居長輩,優先要處理的問題完全不同。
這裡藏著一個陷阱:正確,不等於重要。
AI 給那位媽媽的十幾條資訊可能每一條都對,但沒有一條告訴她,哪一條是她現在該先處理的。這一關,需要一個認識「這個人」的人。
第三次轉譯:知道,變成做得到
病人知道要洗鼻子,跟他今晚真的會洗、而且洗對,中間還有一段距離。
要洗幾次、什麼水溫、洗完還是塞怎麼辦、什麼狀況要回診——沒交代清楚,衛教就停在知道,走不到做到。
(站在病人那一側、同一段路怎麼走,我另外寫過一篇給民眾的版本:用 AI 查症狀前,先過這五關。)
三次轉譯走完,終點不是「病人聽懂了」,而是病人有能力跟你一起做決定。
這就是『醫病共享決策』真正發生的地方:他理解問題、理解選項、也理解風險,然後和你一起選一條路,並且願意為這條路一起努力。
衛教的新可能,與它的界線
當然,診間外的功課也要做。這裡讓數據說一次話。
2024 年《JAMA Otolaryngology–Head & Neck Surgery》一篇系統性回顧 [2],從 3,235 篇文獻中納入 17 份研究,總共評估了 1,124 份頭頸癌的病人衛教資料。結果:各研究的平均閱讀難度落在 8.8 到 14.8 年級之間,沒有任何一項研究的平均值達到美國醫學會建議的『六年級以下』。
同一篇回顧裡還有另一半的落差:有 8 份研究評估了病人的健康識能,不足的比例從 11.9% 到 47.0% 不等;作者的結論是,超過三分之一的頭頸癌病人健康識能不足。
一邊是寫得太難的資料,一邊是讀不動的病人。頭頸癌正是我的專科領域,這個結果我一點都不意外——我們寫衛教時,常常不知不覺是寫給同行看的。
所以我的診所寫網路衛教內容時,順序是固定的:醫師先建立知識骨架、AI 展開成文章與圖卡、醫師再逐字審閱、標註來源、署名負責。醫師負責「對」,AI 負責「快」,順序不能反過來。為什麼診間裡來不及說的話要變成數位衛教,我在〈AI 時代,醫師還剩下什麼?〉談過;這裡要補的是,數位衛教也得走完三次轉譯,否則只是把一張看不懂的單子搬到網路上。
給健康產業的一課
這一課不只給醫療院所。
健康媒體、健康管理 App、保險公司的健康促進部門、藥廠的病友衛教、健檢中心的報告解讀服務——凡是要把專業資訊交到一般人手上的,遲早會發現:產出量,跟使用者真的採取行動,是兩條不同的曲線。
我會建議把三次轉譯直接當成產品規格來檢查:
| 檢查項 | 沒過關的樣子 | |
|---|---|---|
| 一 | 內容有沒有翻成生活語言? | 專有名詞照搬,讀者要另外查 |
| 二 | 有沒有幫使用者做取捨、告訴他哪一條對他最重要? | 條列十項,每項都對,但沒有優先序 |
| 三 | 他看完之後,知不知道下一步具體要做什麼? | 結尾寫「請諮詢專業人士」就結束了 |
AI 時代,能生成內容的人會愈來愈多,產出量不再是護城河。能讓使用者真的動起來的那一段轉譯,才是。
結語
AI 可以讓衛教說得更完整,但只有真正的溝通,才能讓病人知道下一步怎麼走。
〈AI 給了十個答案之後〉談判斷變貴了。這一篇談的是理解——當資訊多到滿出來,能把資訊變成理解、把理解變成行動的能力,反而成了稀缺品。
接下來,我想談這條路上最現實的一題:在 AI 什麼都答得出來的時代,健康產業到底該找什麼樣的人。
(延伸閱讀:關於醫病溝通的基本功,我整理過看診不是把話說完,而是讓對方真的懂。)
免責聲明:本文為醫療趨勢與溝通觀點分享,不針對個別病情提供診斷或治療建議。文中案例已去識別化處理,個別孩子的鼻塞、打呼與注意力問題成因不一,仍請至醫療院所由醫師依個別狀況評估。文中所引研究為特定情境下的結果,不宜直接外推至個別臨床決策。
